언어와 문화를 반영한 AI,
Instruction 데이터에서 시작됩니다
단순 번역된 학습데이터는 그 나라의 문화적 맥락과 논리를 담지 못합니다. 각국의 언어·사고방식·규범·제도를 반영한 현지화 데이터를 자동화된 파이프라인으로 구축해, LLM이 해당 언어권을 가장 잘 이해하도록 학습 성능과 신뢰도를 높입니다.
번역 데이터가 놓치는 것
- 번역 데이터는 문화적 맥락·논리·관용 표현을 반영하지 못합니다.
- 언어별 문법 구조와 사고 흐름(CoT 전개)이 달라 모델 추론 품질에 직접 영향을 줍니다.
- 규범·관습·제도·금칙 표현은 현지 전문가 검수 없이는 확보할 수 없습니다.
“그 나라의 언어, 문화, 제도를 가장 잘 이해하는 AI를 만들기 위해 신뢰도 높은 데이터를 설계하고 구축합니다.”
구축 데이터 유형
CoT · Multi-turn · 현지화
관습 · 제도 · 사회문화 맥락
Pre-training용 대규모 텍스트
규범·문화 · 다문화 평가 문항
대상 언어 · 구축 규모
비영어권 원천 말뭉치
규범·문화 벤치마크
다문화 평가 벤치마크
국가·언어별 말뭉치 확보
문화·규범 적합성 확인
문화·규범 반영 Q&A, CoT
문법·논리·편향·금칙어
Fine-tuning · 벤치마크 평가
LLM Fine-tuning Instruction 데이터 제작 자동화
해외 언어 LLM 구축을 위한 고품질 Instruction 데이터 파이프라인. 현지 언어와 사고방식에 맞춘 Instruction 데이터를 자동 생성하고, 번역이 아닌 문화·규범·문맥에 맞춘 현지화된 학습데이터를 제공합니다.
Instruction 자동 생성 파이프라인
Prompt 기반 Instruction 데이터 자동 생성. 단순 질의응답을 넘어 논리적 사고 흐름(Chain-of-Thought)과 다중 턴 대화 구조(Multi-turn QA)를 포함한 복합 데이터를 생성하며, 베트남어·태국어·크메르어 등 언어별 CoT 전개 구조를 최적화합니다.
다국어 Instruction Fine-tuning 지원
영어에 최적화된 모델을 넘어 로컬 언어 기반 LLM 구축을 위한 다국어 Instruction 데이터 제작. 기계 번역에 의존하지 않고 현지 언어 전문가의 피드백으로 품질을 검증하며, 사회·문화적 맥락을 고려한 일관성 있는 Instruction 구조를 보장합니다.
Instruction 품질 자동 검수·평가 도구
문법(Syntax)·논리적 일관성·응답 명확성·맥락 충실도를 자동 점검하고 오류·이상 응답을 사전에 제거합니다. 편향 표현, 민감 주제, 금칙어 등 위험 요소를 필터링하며 정량 평가지표 기반 리포트로 신뢰성과 완성도를 확인합니다.
RAG + sLLM 기반
데이터 전처리 자동화
생성형 AI 서비스를 위한 RAG(Retrieval-Augmented Generation) 프로세스 기반 데이터 구축. 문서 수집부터 임베딩, Chunk 생성, 표와 이미지 처리까지 전 과정을 자동화·보정할 수 있도록 설계되어 있습니다.
“생성형 AI의 성능은 데이터를 어떻게 준비하는가에 달려 있습니다.”
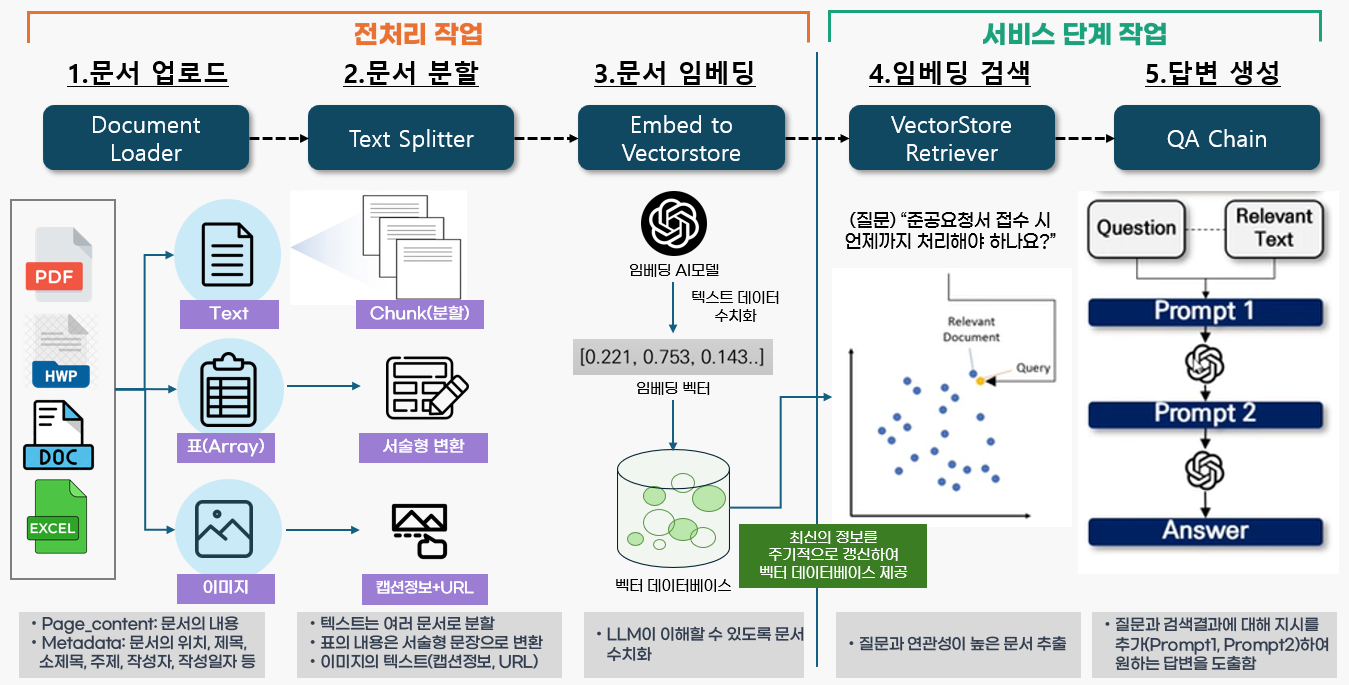
수집 대상 파일(문서) 확정
문서 분류체계, 제목·포맷·작성일·작성자·문서번호
문서파일 저장 · 메타데이터 생성
표·이미지 처리, 벡터 임베딩
개인정보·보안·저작권 준수
주요 수집 대상 문서
관련기관 백서, 정보공개대상 온나라문서, 주요업무계획, 보도자료, 보고서, 사규, 법령, 민원 정보 등
주요 파일 포맷
준수 사항
개인정보보호 및 보안지침, 저작권, 해킹방지 등 준수
LLM 성능평가 벤치마크 데이터셋
초거대 언어모델의 추론(Reasoning) 성능을 객관적으로 측정할 수 있도록 문제 유형·정답 구조·채점 기준이 명확한 성능평가 데이터를 구축합니다. 기존 글로벌 평가 방식이 충분히 반영하지 못하는 한국적 문화·사회 가치를 담은 평가 체계입니다.
평가 데이터 설계
LLM의 추론(Reasoning) 성능을 객관적으로 측정할 수 있도록 Task 정의, 문제 유형, 정답 구조, 채점 기준을 먼저 설계하고 난이도 분포를 맞춥니다.
제작 · 검증 절차
Task 선정 → 규모·난이도 설계 → 원천 수집 → 정제 → 문항 제작 → 전문가 검수 → 모델 평가 → AI Hub 등재까지 단계별 품질 게이트를 운영합니다.
글로벌 규범·문화 벤치마크
다문화 평가용 10개 Task, Task별 1,500개 이상 총 25,000건 이상의 평가 데이터. 베트남어·한국어·영어 3개 언어로 구축하고 GPT·Gemini·Claude·HyperCLOVA 등 다양한 LLM을 평가했습니다.
AI 학습데이터 구축 프로세스
음성·소음·이미지·텍스트 등 종별 데이터를 수집·정제하고, 라벨링 후 크라우드 워커의 2·3차 교차 검수와 DB 전문 인력의 품질 검증을 거쳐 NIA AI Hub 등재 기준의 품질을 확보합니다.
음성·소음·이미지·텍스트 종별 수집
종별 데이터 정제 작업
AI 학습을 위한 라벨링, 1차 검수
크라우드 워커 2·3차 교차 검수, 멀티 작업장
진단 시스템 기반 품질 검증·관리
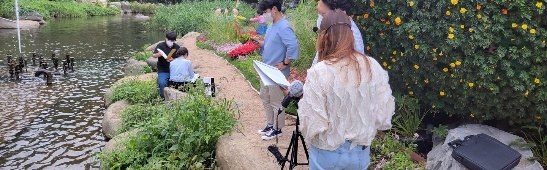
데이터 수집 / 정제 / 가공
종별 데이터 수집 → 정제 → AI 학습용 라벨링 → 1차 검수
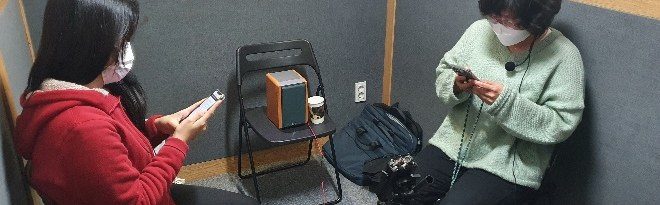
데이터 검수 / 검증
가공에서 이관된 데이터를 크라우드 워커가 2·3차 교차 검수. 작업장·온라인(재택) 병행
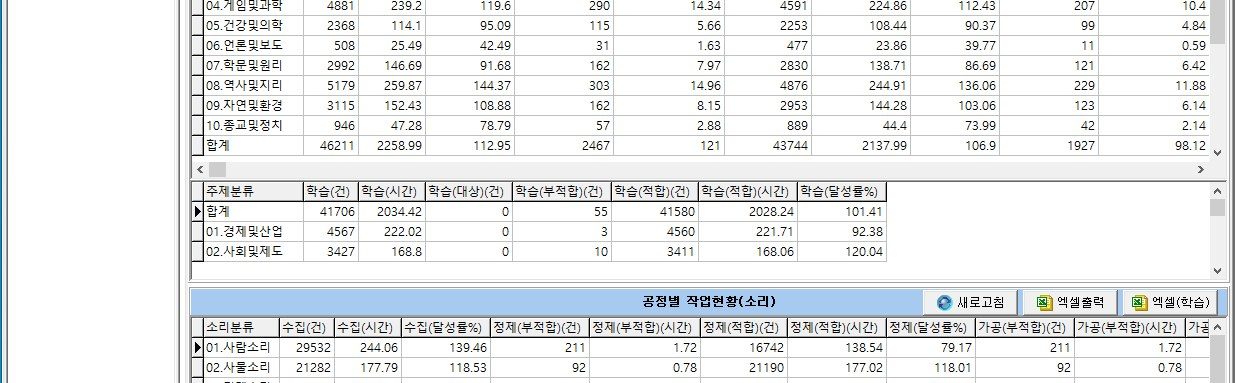
DB 품질 관리
DB 전문 인력 검수, 사업 특화 진단 시스템, NIA AI Hub 등재 기준 품질 확보
데이터 획득 방법 — 현장 · 재택 · 스튜디오
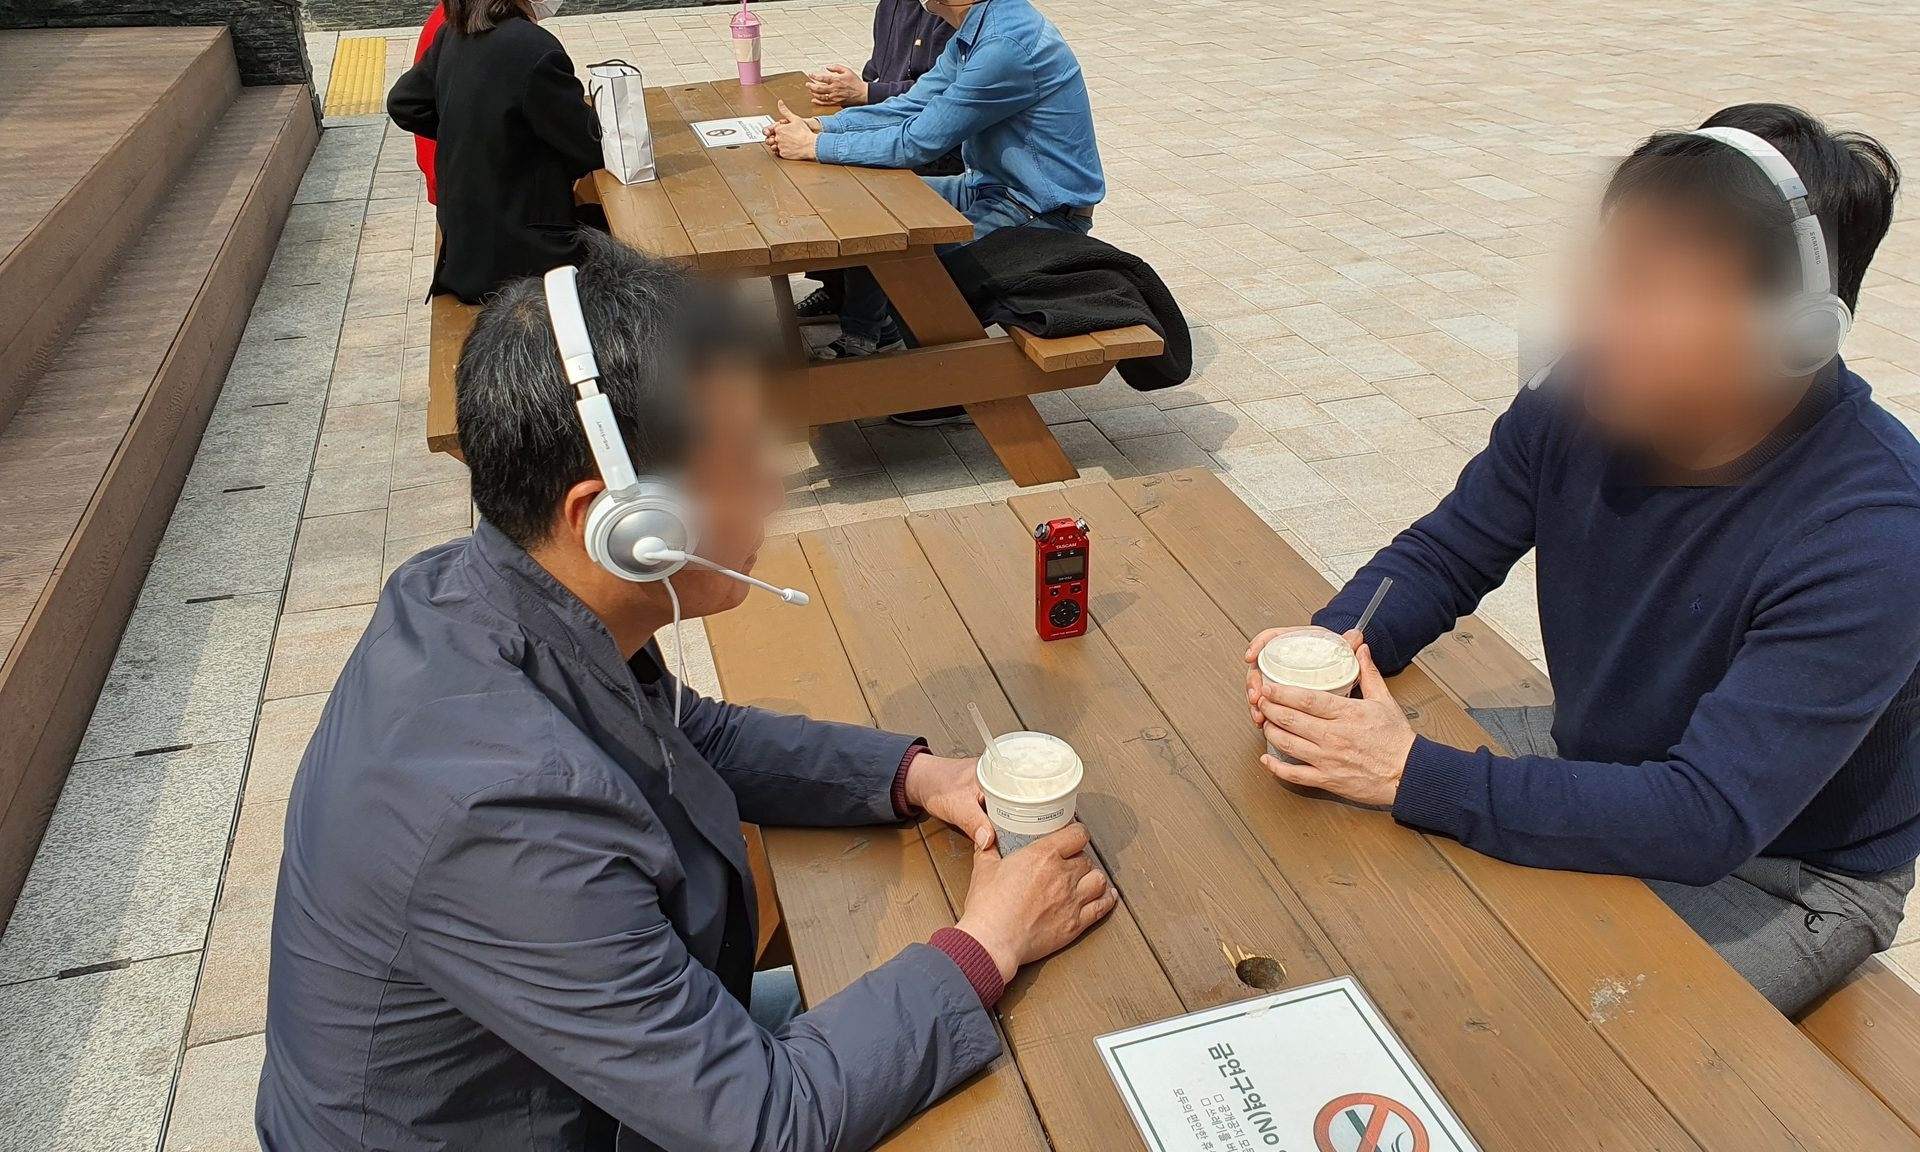
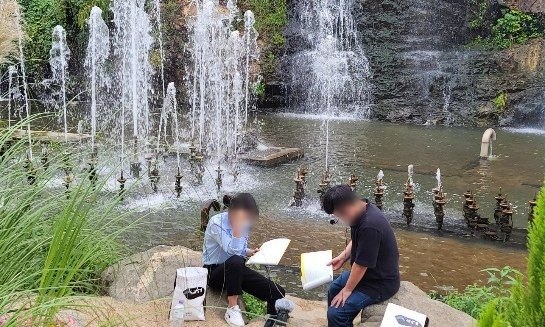
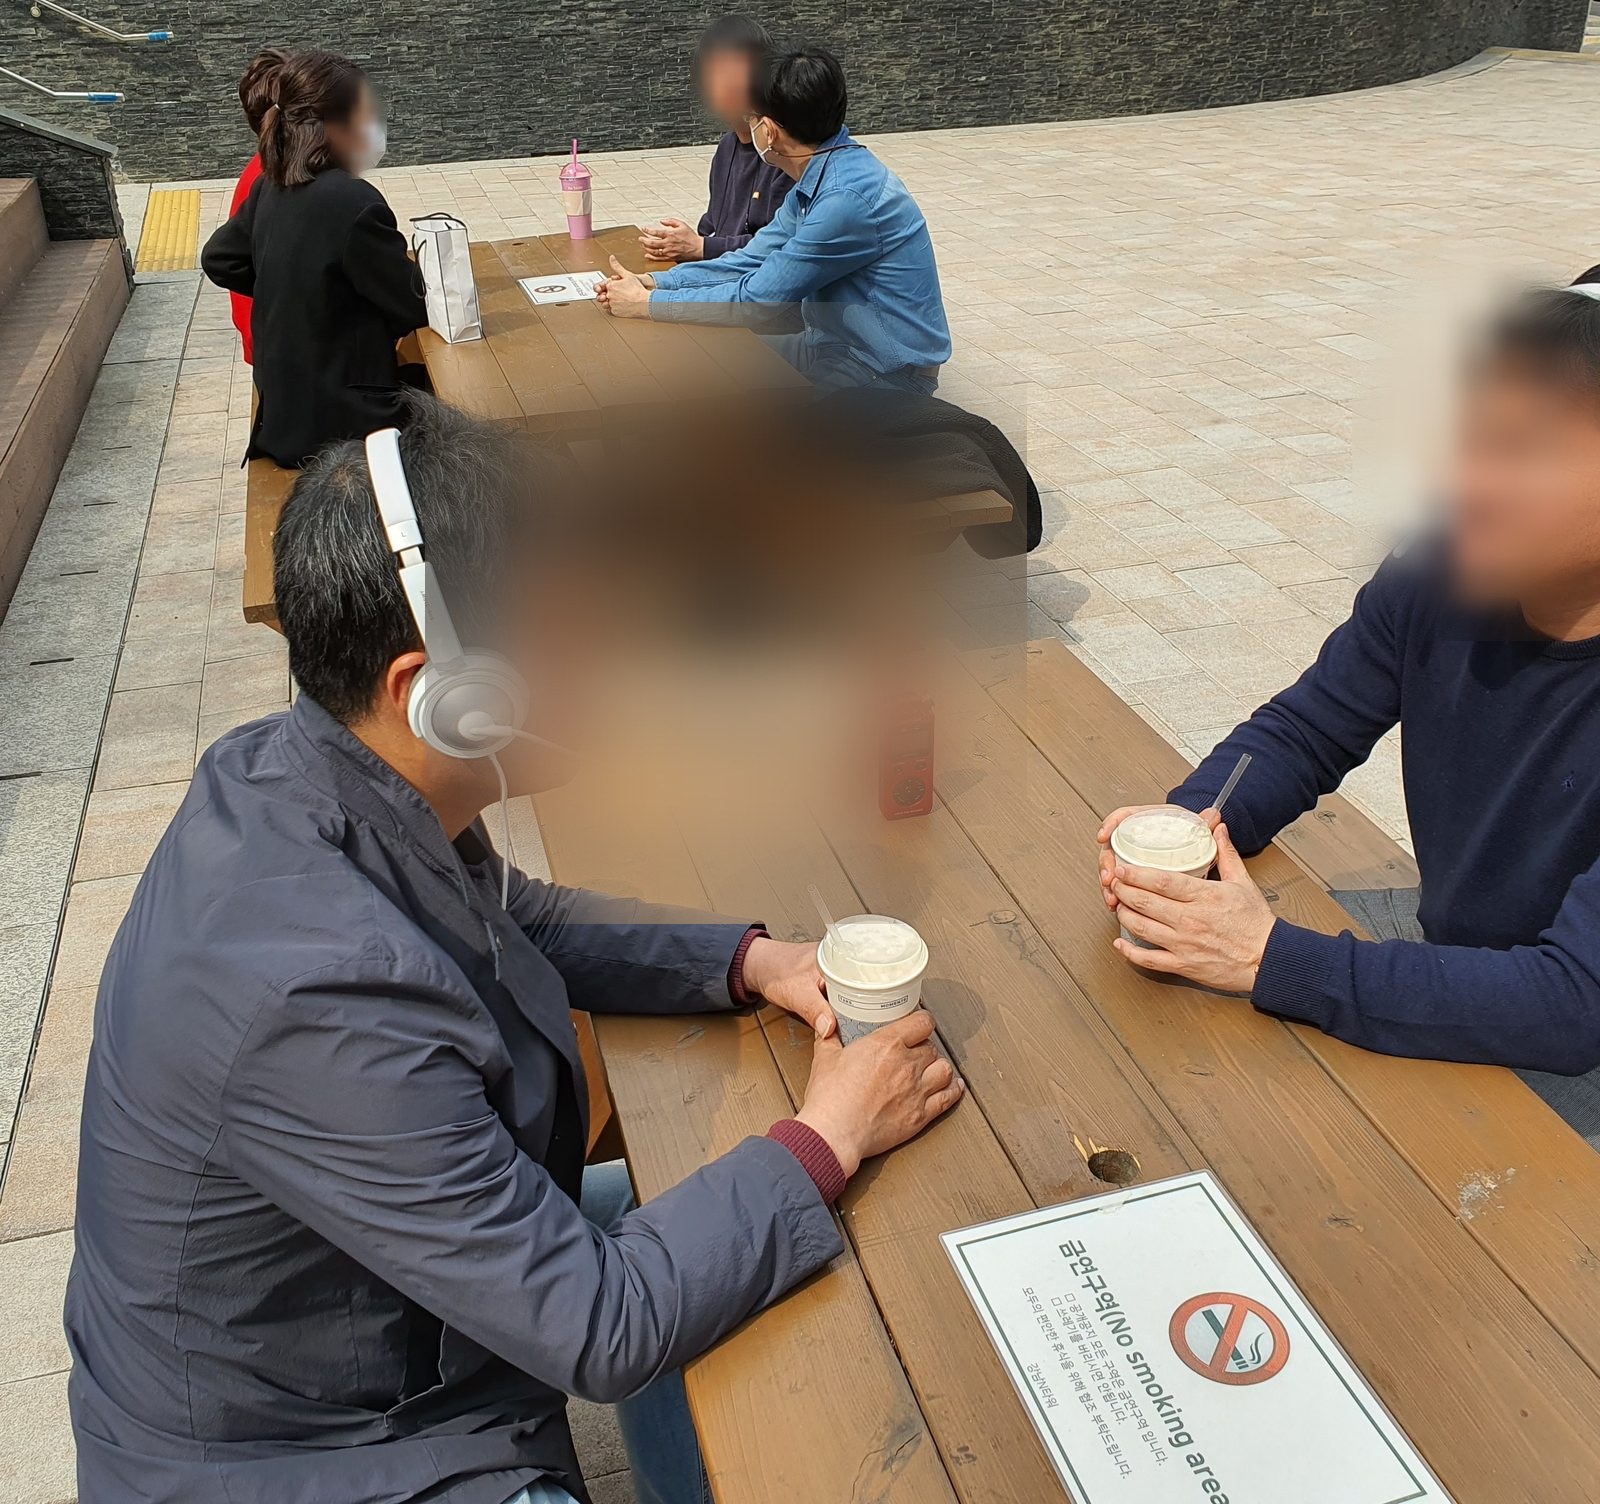
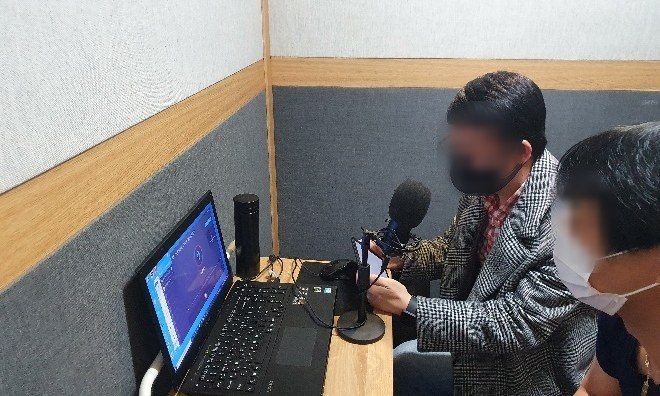
스튜디오·재택·현장을 혼합 운영하여 스크립트 대화, 자유대화, 인위적/자연 소음환경 대화를 모두 확보합니다. 재택 및 직접 고용을 통해 소음 현장에서 직접 대화를 녹음하며 일 150명을 투입했습니다.
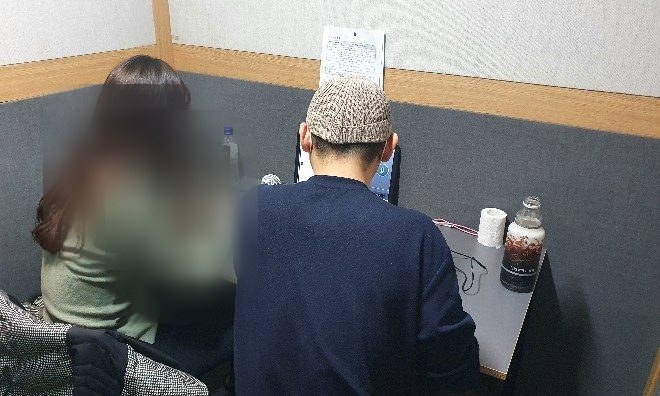
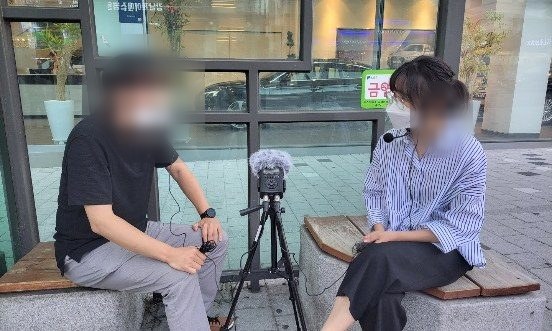
소음환경에서의 대화
주점·식당·카페·통화 등 소음 현장에서 직접 대화 녹음
스크립트 · 자유대화
스크립트 30%로 작업량·전사 품질 향상, 주제 기반 자유대화 70%로 다양성 확보
장비 세트 구성
4채널 멀티트랙 녹음장치 + 노이즈캔슬링 무선 헤드셋 2대로 "화자음성, 소음+화자음성" 동시 녹음
인력 운영
일 150명 투입, 지자체 중장년고용센터 연계, Slang 해커톤·화상대화·게임대화 참여